第二部回答了"业务智能体该如何设计"(原理),第一部回答"普通人如何上手用 AI、如何把 AI 接进自己的系统"(实操)。
如果说第二部是"造车原理",第一部就是"驾驶手册":先学会开常见的几款车(第 1 章),再学会把车接上自己的货(ERP 等系统,第 2 章),接着学会在复杂路况下不翻车、不迷路(降低幻觉,第 3 章),然后学会选车、规划出行路线(选型与落地,第 4 章),最后在"上高速"之前搞懂一个关键问题——通用工具"随机的回答"到了企业为什么必须"守规矩"(第 5 章)。
第一部面向无编程背景的普通用户,所有教程按"能照着做"的标准编写;涉及的产品功能以 2026 年公开版本为准,具体界面以实际为准。
注意事项:第一部介绍的通用产品天然带"随机性"——同一问题两次回答可能不同、该拒绝的未必拒绝、该留痕的未必留痕。对个人这无伤大雅,但直接用于企业业务即构成"不可靠"。企业应用如何消除这种随机性,是第 5 章与第二部共同回答的核心问题。
第 1 章:主流 AI 智能体工具操作实务
1.1 从"聊天机器人"到"行动式 AI"
普通用户接触 AI 的第一印象是"对话"。但 2026 年的主流产品已经完成了从"只会说"到"还能做"的进化,见表 1-1:
表 1-1 AI 工具的四个能力层级
| 能力层级 | 典型产品形态 | 能做什么 | 交付物 |
|---|---|---|---|
| L1 对话层 | 传统聊天 AI | 回答问题、生成文案 | 一段文字 |
| L2 工具层 | 接入搜索/文件的 AI | 联网查资料、读文件 | 带来源的回答 |
| L3 行动层 | AI 智能体(Agent) | 自动拆解任务、读写文件、调用工具 | 文档 / 表格 / PPT / 代码 / 网页 |
核心判断标准:一个 AI 是否"会干活",看它能否交付可验收的成果文件,而不只是一段回复。本章介绍的三款工具(WorkBuddy、TRAE Work、通义千问)分别代表"办公行动派""开发者工作台""全能问答王"三种定位,覆盖绝大多数普通用户场景。
1.2 WorkBuddy:腾讯 AI 办公工作台
1.2.1 定位与本质
WorkBuddy 是腾讯出品的全场景 AI 办公工作台。核心定位是行动式 AI——你一句话说清要做什么,它自动拆解任务、规划步骤、实际操作文件,最终交付可直接使用的成品(Word / PPT / Excel / 网页)。
表 1-2 WorkBuddy 的核心能力
| 能力 | 说明 | 一句话举例 |
|---|---|---|
| 读写本地文件 | 创建、编辑、分析电脑上的文档与表格 | "帮我生成本周项目周报" |
| 执行命令 | 安装环境、跑脚本、处理数据 | "把这个 CSV 去重后排序" |
| 联网查资料 | 搜索最新信息、抓取网页 | "调研 2026 年 AI 行业趋势" |
| 生成多媒体 | AI 画图、生成视频、创建 3D 模型 | "根据大纲做一份 10 页 PPT" |
| 定时任务 | 设置每天自动执行的工作流 | "每天早上 9 点整理昨日行业要闻" |
| 连接外部服务 | 通过 MCP 连接器对接数百个平台 | "查我邮箱最近的邮件" |
1.2.2 安装与登录
- 访问官方站下载 Windows / macOS 客户端;
- 首次打开用微信扫码登录,手机验证后即可使用;
- 新用户通常赠送体验积分,用于抵扣大模型调用。
1.2.3 三种工作模式(务必先理解)
表 1-3 WorkBuddy 三种工作模式
| 模式 | 一句话理解 | 适用场景 | 新手建议 |
|---|---|---|---|
| Craft | 你说我做,立即执行 | 明确任务:写文档、做 PPT、分析数据 | 日常 90% 用它 |
| Plan | 先想后做,出方案确认再执行 | 复杂项目:建网站、大型重构 | 拿不准时切它 |
| Ask | 只问不动,纯问答 | 咨询评估:对比方案、代码审查 | 不想动文件时用它 |
误区提醒:指令太模糊("帮我处理一下这个文件")是新手最大的坑。好指令要说明目标:"把这个文件的重复行删掉,按日期排序,输出新表"。
1.2.4 界面三区导航
WorkBuddy 的界面是经典的"三区"布局:左边找任务、中间下指令、右边收成品,如图 1-1 所示。
- 左侧栏:任务列表(按文件夹分组)、工作空间、搜索筛选;
- 中间对话区:下达指令的核心区域,支持上传文件、粘贴截图;
- 右侧结果区:查看产物、全部文件、变更记录、实时预览——这是"行动式 AI"与普通聊天的关键区别,你拿到的是可下载的成品。
图 1-1 WorkBuddy 界面三区导航(示意图)
1.2.5 模型选择与自定义
底部下拉可选模型:混元(腾讯自研,办公整合最佳)、DeepSeek(推理与代码强)、KIMI(长文本)、智谱(通用)、Auto(自动按任务选择)。也支持填入 OpenAI 兼容协议 API Key 接入自定义模型。
1.2.6 技能(Skills)、连接器(MCP)与专家(Agent)
WorkBuddy 把"能力"拆成三层,见表 1-4:
表 1-4 技能、连接器与助理的概念对照
| 概念 | 本质 | 类比 | 例子 |
|---|---|---|---|
| 技能(Skill) | 能力插件 | 给 AI 装一个软件 | PDF 处理、PPT 生成 |
| 连接器(MCP) | 外部数据通道 | 给 AI 接一根网线 | 腾讯文档、企业微信、GitHub |
| 专家(Agent) | 流程智能体 | 请一个专业顾问 | 数据分析专家、UI 设计专家 |
新手推荐先装:Web Search(联网搜索)、Agent Browser(动态网页抓取)、PDF 处理、Office 文档四件套、数据分析。安装后在对话中 AI 会自动调用。
1.2.7 第一个完整任务(照着做)
- 描述需求:在对话框输入"分析这份销售数据,找出销量 Top5 的产品,画一张月度趋势图",并上传 CSV/Excel 文件;
- 选择模式:保持 Craft;
- 发送:AI 自动读取数据 → 计算 → 生成图表 → 交付分析报告;
- 查看结果:右侧结果区下载 docx / 图表文件。
1.2.8 界面全景:左侧边栏九大入口
WorkBuddy 界面左侧是功能导航区,九大入口覆盖从个人到团队、从手动到自动的全场景,分布如图 1-2 所示,逐条速查见表 1-5:
表 1-5 WorkBuddy 功能入口速查
| 入口 | 功能一句话 | 什么时候用 | 新手优先级 |
|---|---|---|---|
| 助理 | 个人专属 Agent,可接入微信/企业微信远程操控 | 日常办公主力、手机遥控电脑 | ★★★★★ |
| 项目 | 团队共享上下文、任务协作空间 | 团队多人共用一套知识和配置 | ★★★ |
| 专家 | 行业/领域专家 Agent,按角色分工执行任务 | 需要专业领域判断时 | ★★★★ |
| 技能市场 | 安装/管理 Skills 能力插件 | 想让 AI 多一门本事时 | ★★★★ |
| 连接器 | MCP 外部数据通道配置 | 要接邮箱、ERP、第三方系统时 | ★★★ |
| 自动化 | 定时任务、周期触发工作流 | 每天/每周自动执行的重复性工作 | ★★★ |
| 记忆 | 个人偏好、历史对话记忆管理 | 想让 AI 记住某些固定规则 | ★★ |
| 资料库 | 统一存放参考文档、SOP、知识库 | 有大量文件要让 AI 引用 | ★★ |
| 灵感中心 | 提示词模板、案例灵感库 | 不知道怎么写指令时参考 | ★ |
图 1-2 WorkBuddy 左侧边栏九大入口(示意图)
新手路径建议:先把「助理」用好(日常 90% 场景)→ 装 3~5 个核心技能(技能市场)→ 体验一个专家(专家)→ 再玩自动化和连接器。
1.2.9 技能(Skills)全流程用法
技能是 WorkBuddy 的"应用商店"——装了技能,AI 才会干对应的活。技能不是装得越多越好,精准匹配场景最重要。
第一步:找对技能(三种方式)
表 1-6 技能市场的三种使用方式
| 方式 | 操作 | 适用场景 |
|---|---|---|
| 技能市场浏览 | 左侧「技能」→ 按分类筛选 | 不知道有什么,先逛逛 |
| 搜索关键词 | 顶部搜索框输入"PDF""Excel" | 明确知道要什么 |
| 对话中斜杠调用 | 输入框里打 / + 前几个字母 |
已装的技能,快速调用 |
第二步:安装(两个渠道)
渠道 A:技能市场一键安装(新手首选)
- 左侧「技能」→ 找到目标技能 → 点击「安装」;
- 单次安装不超过 10 个,优先装核心款,避免冲突;
- 安装后在对话中 AI 会自动识别并调用,也可以手动
/指定。
渠道 B:命令行 / SkillHub 安装(进阶)
部分第三方技能需要命令行安装,适合开发者。在终端执行安装命令后,回到 WorkBuddy 刷新即可看到。
第三步:调用(两种触发)
表 1-7 技能的触发方式
| 触发方式 | 怎么做 | 什么时候用 |
|---|---|---|
| 自动调用 | 直接说需求,AI 自己判断用哪个技能 | 日常场景,省事 |
| 手动指定 | 输入框打 / 选技能,或明确说"调用 XX 技能做 XX" |
任务复杂、怕 AI 选错技能时 |
避坑提醒(新手常犯): * 技能不是越多越好——装太多会出现技能冲突,AI 反而选错; * 技能和模型要匹配——执行类技能(文档生成、Excel 处理)配执行型模型,分析类技能配推理型模型; * 安装后不会用?先在输入框打
/技能名看说明,或问 AI"这个技能能做什么"。
新手必装技能清单(6 个核心款)
表 1-8 常用内置技能
| 技能名 | 解决什么问题 | 典型用法 |
|---|---|---|
| Web Search | 联网搜索最新信息 | "查一下 2026 年 AI 行业报告" |
| Agent Browser | 动态网页内容抓取 | "提取这个网页的表格数据" |
| PDF 处理 | PDF 阅读、提取、转换 | "把这份 PDF 合同的关键条款列出来" |
| Office 文档四件套 | Word/Excel/PPT 读写排版 | "把这份 Excel 做成 10 页 PPT" |
| 数据分析 | 数据清洗、统计、可视化 | "分析这份销售数据,出 Top10 和趋势图" |
| 批量文件处理 | 文件重命名、格式转换、整理分类 | "把这个文件夹里的图片按日期重命名" |
1.2.10 专家系统:让 AI 以专业身份干活
专家(Expert Agent)是 WorkBuddy 的进阶功能——相当于给 AI 穿上"专业套装",用特定领域的方法论和工具链来执行任务。
专家 vs 技能 vs 专家团
表 1-9 技能与连接器的区别
| 概念 | 本质 | 一句话理解 |
|---|---|---|
| 技能(Skill) | 工具能力 | 让 AI 会"做某件事" |
| 专家(Agent) | 角色 + 方法论 + 工具链 | 让 AI 以"某个领域的专家"身份干活 |
| 专家团(Team) | 多位专家分工协作 | 让一个团队的 AI 配合完成复杂项目 |
一句话记忆:Skill 是能力,专家是能力加经验,专家团是多位专家加协作流程。
使用专家的三种方式
- 直接调用内置专家:左侧「专家」→ 按行业分类浏览 → 点击使用 → 输入需求;
- 对话中切换:输入
@专家名后跟需求,如@数据分析专家 帮我分析这份报表; - 创建自定义专家:点击「创建专家」→ 填写角色定位、擅长领域、工具配置、工作流程 → 保存后即可调用。
专家团适用场景
当任务涉及多个专业角色协作时(如"做一个产品发布方案"需要文案 + 设计 + 数据分析 + 市场调研),专家团模式自动拆解任务、并行执行、汇总交付,效率远高于单 Agent 反复追问。
1.2.11 自动化:定时任务无人值守
自动化(Automation)就是"定时触发的 AI 工作流"——设定好时间和任务,WorkBuddy 到点自动执行,结果推送给你。
典型场景
表 1-10 定时任务场景示例
| 场景 | 触发频率 | 任务内容 |
|---|---|---|
| 每日行业简报 | 每天早上 9:00 | 抓取行业资讯 → 筛选重点 → 生成简报 → 推送微信 |
| 周报自动生成 | 每周五下午 | 汇总本周项目文档 → 提取进展与风险 → 生成周报 |
| 数据日报 | 每天晚上 8:00 | 读取业务系统数据 → 统计关键指标 → 生成日报 PDF |
| 文件定期备份整理 | 每周日凌晨 | 扫描指定文件夹 → 分类归档 → 重命名 → 清理临时文件 |
配置五步走
- 左侧「自动化」→ 点击「新建自动化」;
- 设置触发条件:时间(每天/每周/每月)或事件触发;
- 填写任务描述——越具体越好,参考 1.3.4 的"六格任务卡";
- 选择执行用的 Agent、模型和工作空间;
- 设置结果推送方式(客户端通知 / 微信 / 保存到指定文件夹)。
注意:自动化任务建议先用手动方式跑通验证,再设置成自动——直接自动化容易因为指令不清晰导致每次结果都不对。
1.2.12 进阶:远程控制(Claw 模式)
WorkBuddy 的杀手级功能之一:手机就能操控电脑上的 AI。
支持的渠道
- 微信 / 企业微信;
- QQ;
- 飞书;
- 钉钉。
配置流程(以微信为例)
- 左侧「助理」→ 找到「Claw 远程控制」开关;
- 用微信扫码绑定(或企业微信管理员统一配置);
- 绑定后直接在微信里发消息,WorkBuddy 会在电脑上执行并回传结果;
- 可以设置"仅语音触发""需要确认后才执行"等安全选项。
安全提醒
- 远程控制默认只读模式(只查不改),需要手动开启写操作权限;
- 重要文件操作建议开启"执行前确认"——AI 会先把计划发给你,你点头才动手;
- 企业版支持管理员统一配置权限策略,详见第 12 章权限设计。
1.2.13 学习路径:从新手到高手
表 1-11 WorkBuddy 学习路线
| 阶段 | 时长 | 掌握内容 | 标志 |
|---|---|---|---|
| 入门期 | 1~3 天 | 安装登录、Craft 模式跑第一个任务、上传文件做数据分析、Ask 模式提问 | 能独立交付一份文档/分析报告 |
| 熟练期 | 1 周 | 熟练切换三种模式、Plan 模式规划中等项目、安装 5~8 个常用技能、连接腾讯文档/邮箱 | 能应对日常办公 80% 场景 |
| 进阶期 | 2~4 周 | 会用专家系统、配置 3+ 个连接器、接入微信/钉钉远程操控、搭建自动化工作流、优化记忆与规则 | 有一套自己的 AI 工作流体系 |
| 精通期 | 1~2 月 | 能开发自定义 Skill、搭建专家团协作流程、企业级治理配置、成本优化 | 能在团队内推广和培训 |
1.2.14 进阶:企业版三产品矩阵
当从个人使用升级到企业部署时,WorkBuddy 不是单一产品,而是三款产品组成的一体化矩阵(以腾讯云 WorkBuddy Enterprise 为底座),覆盖从个人到团队再到平台工程的全场景,见表 1-12:
表 1-12 腾讯 AI 产品矩阵
| 产品 | 定位 | 目标用户 | 核心能力 |
|---|---|---|---|
| CodeBuddy | AI 原生全流程编程工具 | 产品、设计师、全栈开发者 | 智能需求转 PRD、设计稿转代码、全流程 AI 编程、一键部署 |
| WorkBuddy | 全场景职场 AI 智能体桌面工作台 | 产品、运营、研发、职能等全岗位 | 自然语言任务理解、自主多步骤规划、本地文件自动化、可验收结果交付 |
| WorkBuddy Managed Agents | 云端托管的智能体运行服务 | 企业 IT、平台工程、Agent 开发者 | 全流程 Agent 生命周期治理、Agent Runtime 沙箱、弹性算力、从十几到数万规模无需重构 |
Managed Agents 的工程价值值得特别关注——它把第二部第 16 章讲的"运行时基础设施"做成了开箱即用的云服务:
- 独立沙箱:每个 Agent 运行在独立隔离环境中,互不干扰,安全边界清晰;
- 全链路 Trace:从规划、执行到交付,每一步都可追溯,满足审计要求(呼应第 12 章);
- 秒级 COW Fork:Copy-On-Write 机制实现快速复制运行环境,应对突发流量;
- 端口转发与预热池:保证冷启动延迟可控,高并发下仍稳定。
企业选型建议:如果团队主要是办公提效,WorkBuddy 桌面版够用;如果有大量开发需求,叠加 CodeBuddy;如果要构建企业自有 Agent 并规模化运行,Managed Agents 是底座级别的选择。
1.3 TRAE Work:字节 AI 原生工作台
1.3.1 定位与三端覆盖
TRAE Work 是字节跳动推出的 AI 原生工作台(由 TRAE SOLO 升级而来),提供网页版、桌面版、移动版三端,数据实时同步。核心逻辑同样是"你提任务,AI 执行"。
表 1-13 TRAE Work 版本对照
| 版本 | 适用场景 | 亮点 |
|---|---|---|
| 网页版 | 临时需求、快速验证 | 无需安装,有网即用(仅云端环境) |
| 桌面版 | 长期开发、复杂项目 | 本地 + 云端双环境,性能更强 |
| 移动版 | 碎片化场景 | 按住说话下发任务,三端同步 |
1.3.2 三种模式:Work / Code / Design
TRAE Work 在界面左上角提供三个模式标签,按角色切换,如图 1-3 所示。三种模式的面向人群与核心能力见表 1-14。
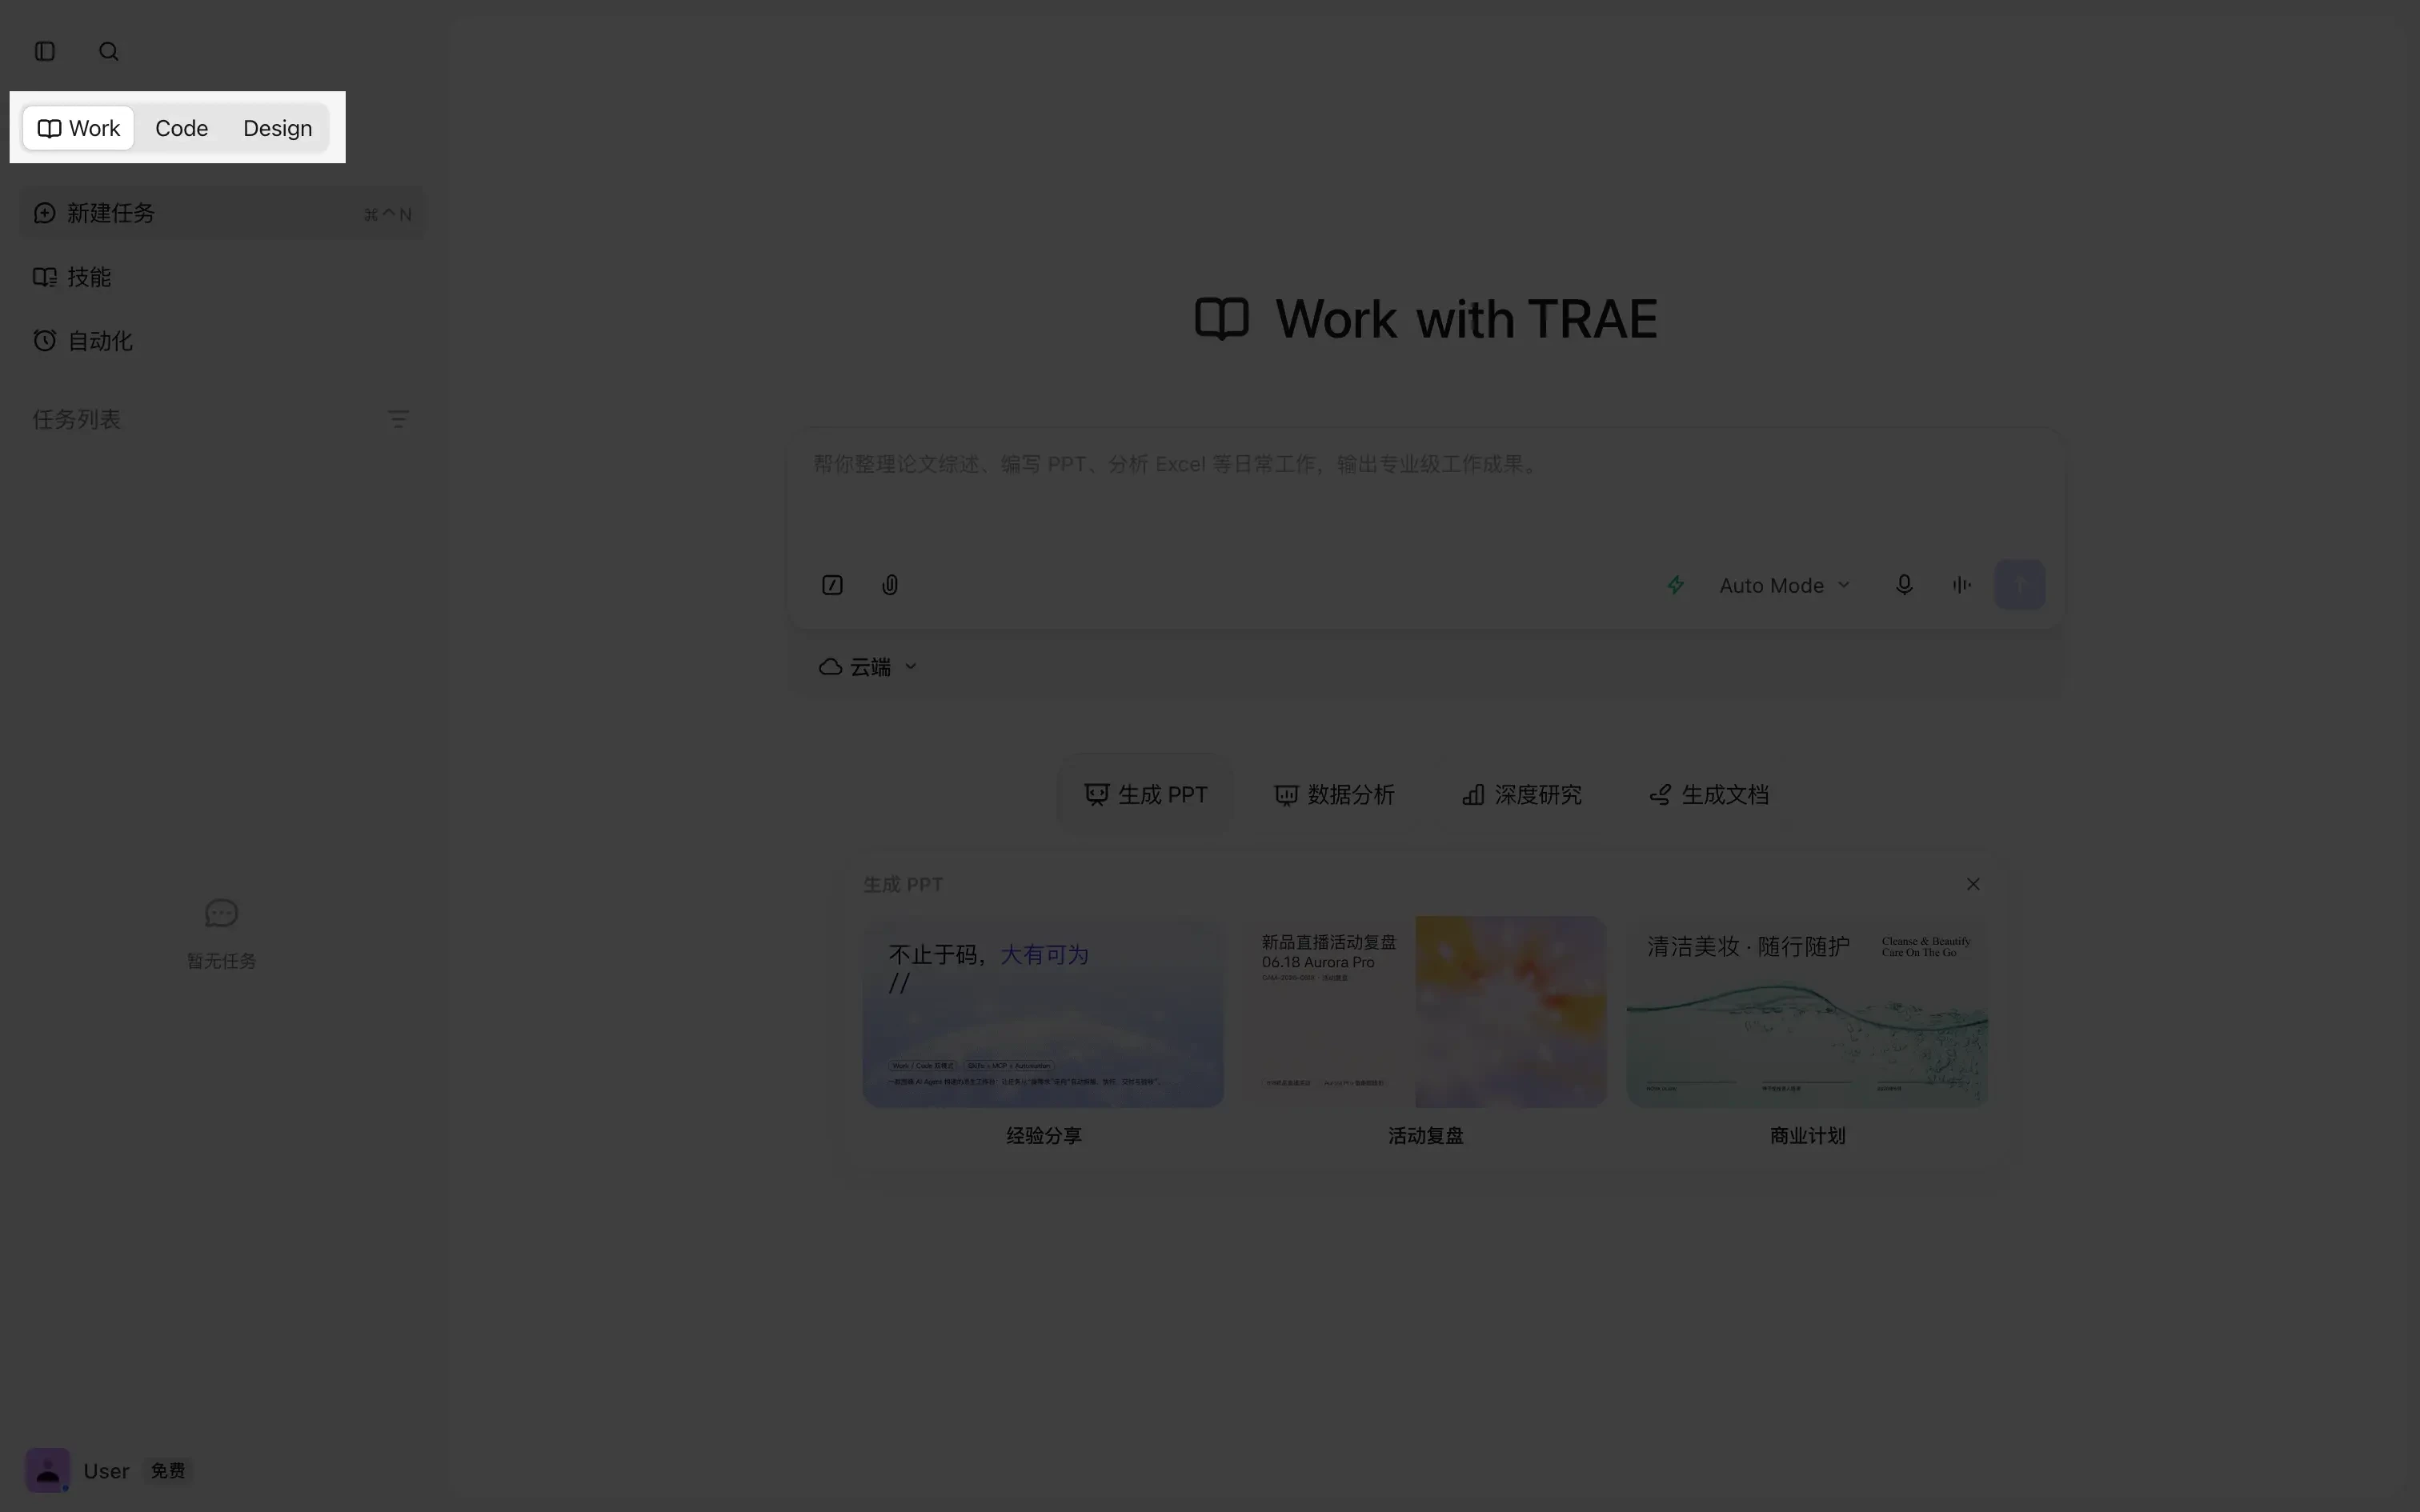
图 1-3 TRAE Work 左上角的三种模式切换(来源:TRAE 官方文档)
表 1-14 TRAE Work 三种模式
| 模式 | 面向人群 | 核心能力 |
|---|---|---|
| Work | 产品经理、数据分析师、运营等非开发人员 | 文档处理、数据分析、演示稿、调研报告 |
| Code | 开发工程师 | 编码、调试、代码库管理、Git 工作流 |
| Design | 设计师与产品创意人员 | 深度兼容 Figma,一键生成视觉与交互 |
1.3.3 发起任务与工作区
在左上角切换模式 → 选择或创建项目 → 输入任务指令 → 发送。支持文字、语音、附件(.pptx / .xlsx / .pdf 等)、图片、斜杠命令、技能(Skill)。发起任务时的输入区与环境选择如图 1-4 所示。
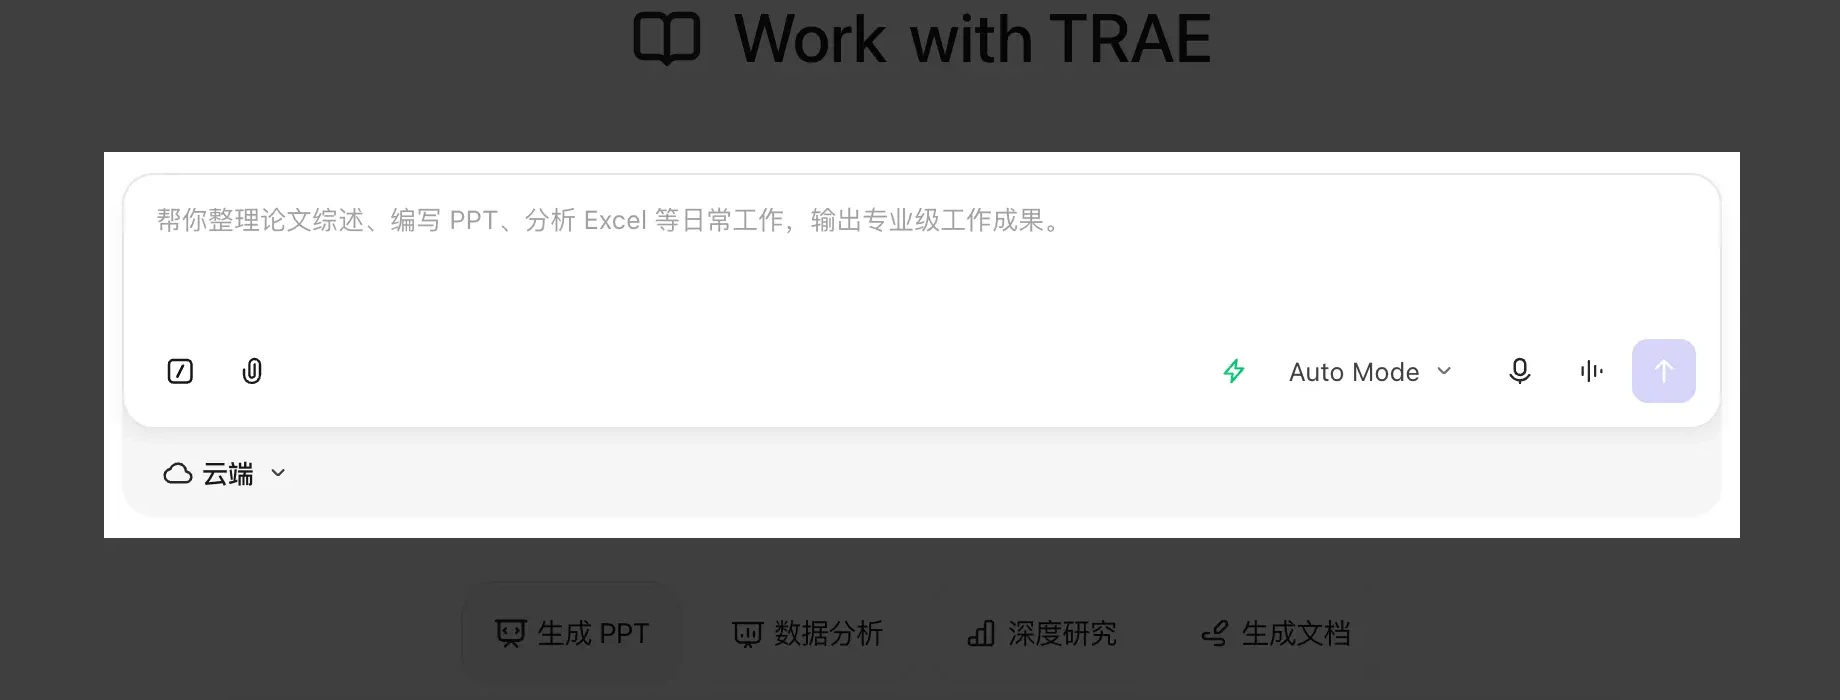
图 1-4 TRAE Work 发起任务:输入区与云端环境选择(来源:TRAE 官方文档)
工作区共四个面板,如图 1-5 所示:
- 对话面板:实时对话;
- 待办(Todos):复杂任务时 AI 列出任务计划,实时追踪子任务进度;
- 任务产物:存放 AI 生成的文件;
- 参考信息:显示 AI 引用的技能、文件、网络信息,可点击"压缩"控制上下文。
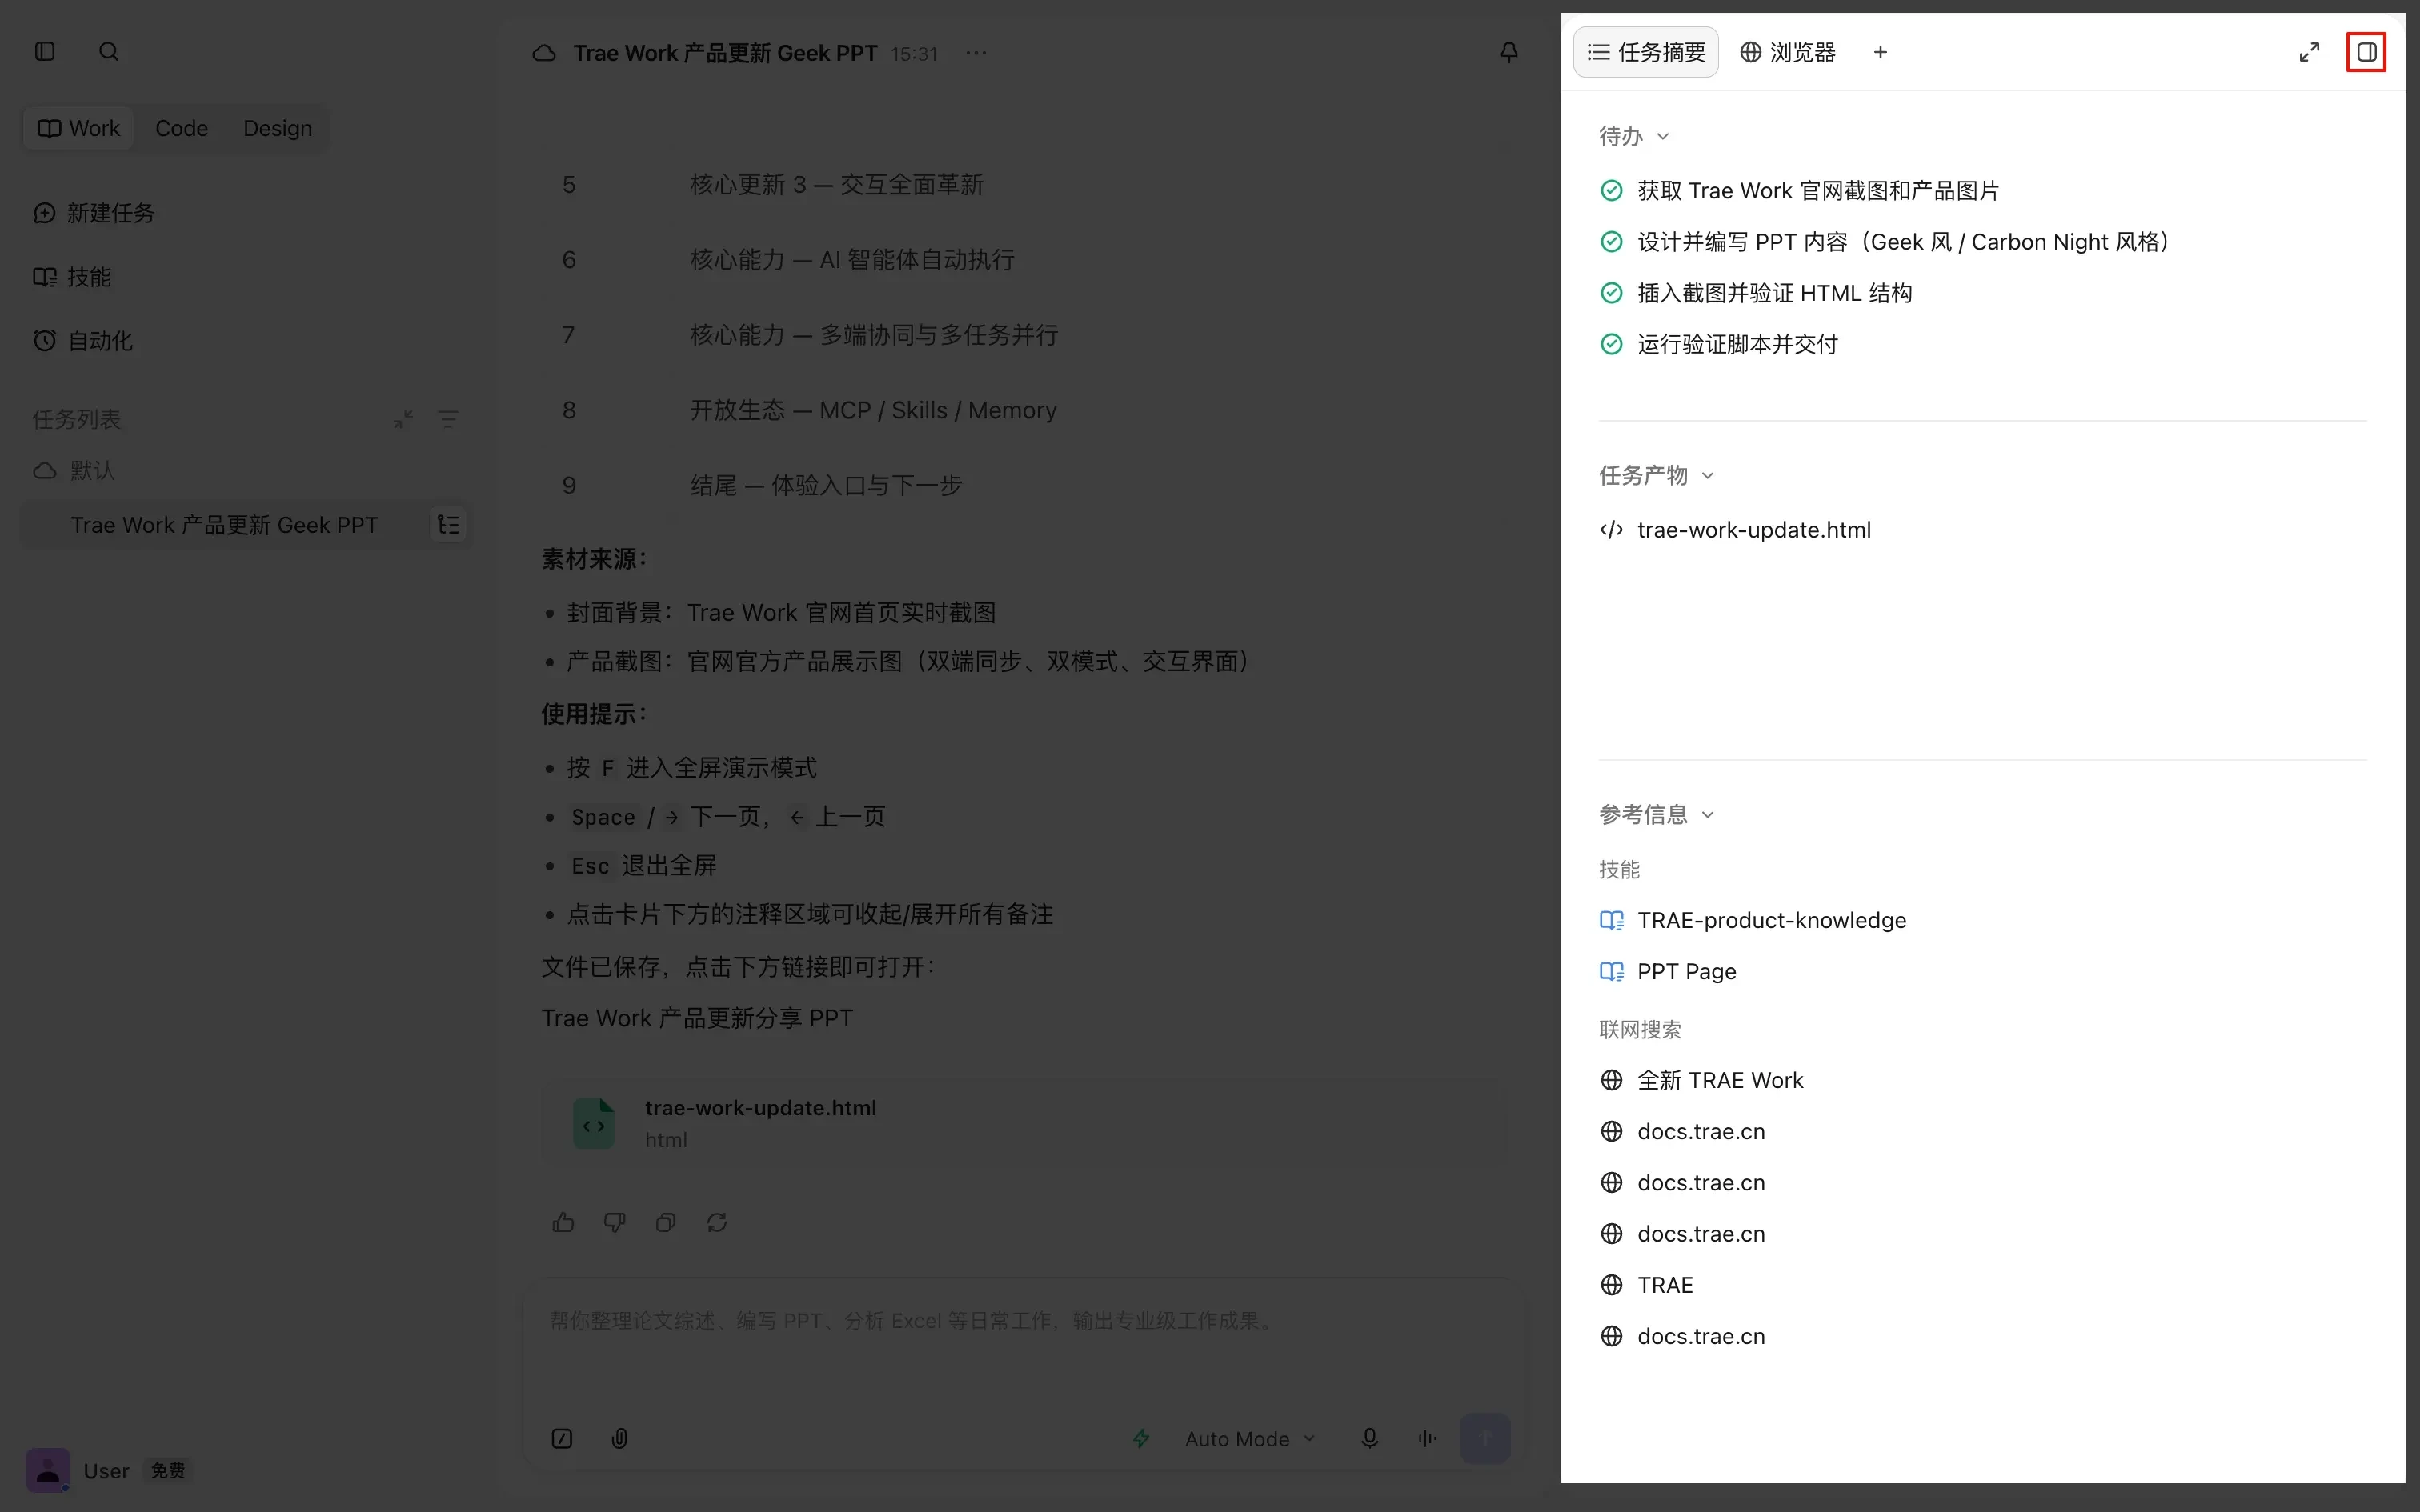
图 1-5 TRAE Work 工作区四面板(来源:TRAE 官方文档)
1.3.4 用"六格任务卡"减少返工
积分消耗最大的场景是需求没说清导致的反复修改。提交任务前写清六项内容,可显著减少返工,见表 1-15:
表 1-15 六格任务卡
| 格 | 内容 | 示例 |
|---|---|---|
| 目标 | 最终要解决什么问题 | 生成一份产品上线通知邮件 |
| 范围 | 允许检查和修改哪些文件/模块 | 只动 docs/ 下的文件 |
| 已知信息 | 已确认的现象、报错、环境 | 标题是 X,收件人是 Y |
| 约束 | 哪些不能修改、能否加依赖 | 不引入新依赖 |
| 验收标准 | 满足哪些条件算完成 | 邮件含三段:上线时间/功能/注意事项 |
| 执行要求 | 先检查再修改,完成后跑哪些验证 | 完成后通读一遍语法 |
1.3.5 规则 + 记忆:一次配置,永久遵守
在"设置 → 规则"中创建规则,AI 在所有对话中都会遵守。例如:"所有回答使用中文""代码风格遵循 PEP8""涉及金额必须带单位"。这是把个人偏好固化为 AI 行为的最简单方式,与第二部第 14 章"可训练配置"的思想同源。
1.3.6 拓展能力:GitHub 集成 / MCP / 技能
- GitHub 集成:授权后可让 AI 自动创建 PR、管理代码库;
- MCP:通过模型上下文协议连接外部工具与服务;
- 技能(Skills):为 AI 提供"专业能力说明书",在特定领域表现更出色。
1.3.7 任务全流程:从发起到验收的完整路径
TRAE Work 的 Work 模式遵循"你提任务 → AI 规划执行 → 你验收结果"的闭环。完整流程分六步,如图 1-6 所示:
图 1-6 TRAE Work 任务全流程六步闭环
flowchart LR
    A[① 新建任务<br>选模式+工作区] --> B[② 描述需求<br>六格任务卡法]
    B --> C[③ 查看进度<br>待办/对话实时追踪]
    C --> D[④ 预览产物<br>工具面板查看]
    D --> E[⑤ 验收反馈<br>满意/修改/重做]
    E --> F[⑥ 沉淀复用<br>保存到项目]
① 新建任务
- 左上角确认当前模式(Work / Code / Design);
- 点击「+ 新对话」或快捷键
Ctrl + N; - 选择工作区(Workspace):是本地文件夹还是云端工作区——这决定 AI 能访问哪些文件;
- 可选:先上传相关文件(拖拽到输入框,或点击附件按钮)。
关键提醒:一定要选对工作区。不选的话 AI 在临时空间里干活,文件散,还可能访问不到你想让它处理的资料。
② 描述需求
参考 1.3.4 的「六格任务卡」。写得越具体,返工越少。一个好的任务描述 = 目标 + 背景 + 约束 + 验收标准。
新手常见的"模糊表述" vs "清晰表述",见表 1-16:
表 1-16 模糊表述与清晰表述对照
| 模糊表述 ❌ | 清晰表述 ✅ |
|---|---|
| "帮我处理一下这个文件" | "把这个 Excel 里的销售数据按月份汇总,生成柱状图,输出为新的 xlsx 文件,放在原文件夹" |
| "写个周报" | "根据附件里的本周项目文档,生成一页周报,分三部分:本周完成、下周计划、风险问题。字数控制在 500 字内" |
| "分析一下数据" | "分析这份销售数据 Excel,找出销售额 Top5 的产品和同比增长率,输出 200 字以内的结论 + 一张趋势图" |
③ 查看进度
任务启动后,可以从三个维度追踪进度:
- 对话面板:看 AI 当前在做什么(思考过程、调用的工具、读取的文件);
- 待办面板(Todos):AI 自动拆解的子任务列表,打勾的是已完成的;
- 进度条 / 状态徽章:顶部显示当前阶段(规划中 / 执行中 / 已完成)。
小技巧:任务执行过程中随时可以打断。在输入框发消息就可以——AI 会停下当前操作,回应你的新指令。
④ 预览产物
AI 生成的文件会出现在工具面板中,可以直接在界面内预览:
- 文档类(docx / md / txt):直接在右侧预览,支持滚动查看;
- 表格类(xlsx / csv):预览前 100 行数据,可切换 sheet;
- 图片类(png / jpg / svg):直接渲染预览;
- 代码类(py / js / html):语法高亮预览,html 还可以直接运行预览网页效果。
⑤ 验收反馈
预览后有三种操作,见表 1-17:
表 1-17 验收与反馈的常用说法
| 操作 | 什么时候用 | 怎么说 |
|---|---|---|
| 确认交付 | 结果满意,可以用了 | "没问题,就这样"或关闭对话 |
| 局部修改 | 大体可以,某几处要调 | "第三部分写得太简了,补充两个案例"或"图表颜色改成蓝色系" |
| 整体重做 | 方向不对,需要重来 | "方向错了,应该是 XX 角度,重新做一份" |
验收是你的权利,也是责任——AI 交付的是"初稿"还是"终稿",取决于你的验收标准有多严格。
⑥ 沉淀复用
做得好的任务可以沉淀下来:
- 保存为模板:把好的任务描述存成快捷指令,下次一键复用;
- 加入项目知识库:把成果文件加入项目,以后的任务 AI 会自动参考;
- 配置成规则:如果是固定格式/风格要求,写到「设置 → 规则」里,以后所有对话都遵守。
1.3.8 文件管理:工作区与文件操作
TRAE Work 强在"文件原生"——AI 操作文件就像你自己操作一样直观。
工作区(Workspace)概念
工作区就是 AI 的"活动范围",分三类,如图 1-7 所示:
- 本地工作区:你电脑上的一个文件夹。AI 只能读写这个文件夹里的文件,外面的碰不到——安全;
- 云端工作区:存在 TRAE 云端的项目空间。多端同步、设备离线也能跑;
- 临时对话:不指定工作区时使用,文件存在临时目录,定期清理。
选择建议:
- 长期项目 → 本地工作区(固定文件夹);
- 多设备协作 → 云端工作区;
- 临时快速问一下 → 临时对话。
图 1-7 TRAE Work 三类工作区与选择建议(示意图)
文件操作五种方式
表 1-18 文件上传的五种方式
| 方式 | 操作 | 适用场景 |
|---|---|---|
| 拖拽上传 | 直接把文件拖进对话区 | 单个/少量文件 |
| 附件按钮 | 点击输入框旁的📎按钮 | 精确选择文件 |
| 工作区直接读 | AI 自动读取工作区内的文件 | 已加入工作区的项目文件 |
| 粘贴截图 | Ctrl + V 粘贴剪贴板里的图片 |
截图说明问题 |
| 斜杠引用 | 输入 /file 选文件 |
要精确引用某个具体文件时 |
1.3.9 对话技巧:追问、修正与迭代
一次对话就是一次协作。以下是提升效率的对话技巧:
黄金原则:一次只说一件事
把大任务拆成小任务,逐个完成。不要一次塞十个需求——AI 顾不过来,容易丢三落四。
三种高效追问方式
表 1-19 多轮追问的三种方式
| 追问方式 | 示例 | 效果 |
|---|---|---|
| 补充信息 | "补充一下:目标用户是 30~40 岁的职场女性" | 给 AI 更多上下文,结果更精准 |
| 局部修改 | "第 2 页的图表改成折线图,其他不变" | 只改指定部分,不浪费算力重做全文 |
| 要求解释 | "你为什么这么分析?给我看下计算过程" | 让 AI 展示推理链条,验证可信度 |
用好"重新生成"和"换模型"
- 对结果不满意 → 先试试"重新生成"(同样的要求再跑一次);
- 连续两次都不行 → 考虑换模型(推理不够换强模型,格式不对换执行型模型);
- 还是不行 → 大概率是需求描述有问题,回头把任务描述写清楚。
1.3.10 三端协同:网页 + 桌面 + 移动
TRAE Work 的一个核心优势是三端联动——同一个账号体系下,任务数据实时同步,设备之间可以"接力"工作,见表 1-20:
表 1-20 TRAE 各端形态对照
| 端 | 形态 | 典型场景 | 核心价值 |
|---|---|---|---|
| 桌面版 | 独立客户端,不依赖 IDE | 长期项目、复杂开发、深度办公 | 性能强、本地 + 云端双环境、交互丰富 |
| 网页版 | 浏览器直接访问 | 临时需求、快速验证、外出办公 | 免安装、即用即走、不占本地资源 |
| 移动版 | App / 小程序 | 碎片化时间、通勤路上、现场调度 | 按住说话下达指令、跨设备任务管理、离线自动切云端 |
典型工作流:
- 早上通勤时,用移动版发语音"整理昨天的项目进度,生成一页简报";
- 到公司,打开桌面版继续细化,AI 已在云端跑了大半;
- 出差路上,用网页版查看结果、做批注,随时验收。
这种"端 + 云"的架构与第二部第 16 章"运行时基础设施"中的计算与交互分离思想一致——重计算放云端,交互放端侧,设备只是"窗口",任务本身在云端持续运行。
1.3.11 云端智能体(Cloud Agent)
桌面版支持本地环境和云端沙箱两种运行模式。云端沙箱的价值在于:
- 环境一致性:统一的运行时和依赖管理,不会出现"我本地能跑你那跑不了"的问题;
- 隔离安全:代码在隔离环境中执行,不会污染本地或泄露数据;
- 持续运行:关电脑也不中断,长任务在云端继续推进;
- 弹性算力:需要大算力时自动扩容,不受本地机器限制。
什么时候该用云端模式?
- 需要安装大量依赖、怕污染本地环境 → 云端;
- 任务要跑很久(数据清洗、批量处理)→ 云端;
- 需要多人协作看同一份运行结果 → 云端;
- 涉及本地私密文件、不想上传 → 本地。
1.3.12 企业版:效能可量化
TRAE 企业版提供的不只是"更好用的 AI",更是"看得见效果"的 AI——它把 AI 的使用效果量化成可追踪的指标,见表 1-21:
表 1-21 团队效能看板
| 维度 | 能力 | 解决什么问题 |
|---|---|---|
| 效能看板 | AI 生成率、AI 代码量、活跃度实时追踪 | "AI 到底帮我们省了多少时间"有数据可查 |
| 成本可控 | 企业费用上限、实时消耗监控 | 月底不"惊喜",预算可预测 |
| 使用透明 | 成员激活状态、工具使用次数全掌握 | 谁在用、用在哪、用了多少,一目了然 |
| 多部署模式 | SaaS、VPC 可选 | 匹配不同安全合规等级 |
| 自定义能力 | 企业规则、知识库、Agent 配置 | AI 说"公司的话"、懂"公司的事" |
企业版特别强调"用后即抛、不训练模型"——数据全链路加密传输,云端零存储,模型不可训练、无日志存储。这与第二部第 12 章"数据安全与隐私保护"的原则一致。
1.4 通义千问:全能问答与文档处理
1.4.1 定位
通义千问(qwen.ai / qianwen.com)是阿里巴巴的大模型助手,覆盖网页、App 与 API(百炼平台)。在长文本、文档处理、中文理解上表现突出,2026 年多个国际评测中位列全球第一梯队。
1.4.2 模型选择:轻/中/重搭配
通义千问区分多个模型,需要手动选择默认模型(提问无法自动触发切换),见表 1-22:
表 1-22 通义千问模型选型
| 模型 | 定位 | 适用场景 |
|---|---|---|
| Qwen-Turbo | 快速、省资源 | 查天气、转述通知、格式整理 |
| Qwen-Plus | 均衡型 | 写邮件、润色文案、日常问答 |
| Qwen-Max | 强推理、长上下文 | 数学证明、代码调试、合同条款比对 |
切换路径:网页端点击头像 → 设置 → 模型偏好 → 设为默认;注意新开的对话才应用新模型。三档模型的分工与切换路径如图 1-8 所示。
图 1-8 通义千问模型选型与切换路径(示意图)
1.4.3 深度思考模式
深度思考模式仅对 Qwen-Max 生效。开启后响应变慢,但推理链条更完整,复杂问题的质量显著提升。激活:对话输入框上方「…」→ 深度思考;或 App「我的 → 设置 → AI 能力 → 深度思考」。注意:在 Qwen-Turbo 下开启会被静默忽略,不生效。
1.4.4 五个高频实用功能
- 文档处理:拖入 PDF / Word / Excel,问"这份合同有哪些对我不利的条款?""总结报告核心观点",长文本自动读完;
- AI 搜索 + 热点追踪:输入话题,自动抓取多源信息,生成带来源标注的综述;
- 代码调试:把报错信息完整贴入 + "分析这个报错问题出在哪",再追问"怎么改";
- PPT 大纲:输入主题,AI 生成每页标题与要点,再点击导出 PPT 自动排版;
- 翻译 + 文化适配:翻译成目标语言并调整表达习惯,适配海外受众。
1.4.5 进阶:CLI 与 API 参数
对命令行用户,通义千问 CLI 支持 :conf temperature=0.3 降低随机性、:conf max_new_tokens=512 限制长度。temperature 越低答案越稳定(见第 3 章),是降低"乱讲"的关键参数之一。
1.4.6 百炼平台:从零搭建企业智能体
如果说通义千问网页版是"个人 AI 助手",那么阿里云百炼就是面向企业和开发者的"AI 工厂"——一站式大模型开发与应用平台,集成千问及主流第三方模型。
百炼的核心价值在于:零代码也能搭建一个可用的企业级智能体。不需要写代码,不需要懂算法,通过可视化配置就能把"大模型 + 知识库 + 插件 + 工作流"组装成一个 Agent。
百炼的三层能力模型
表 1-23 通义千问的能力分层
| 层级 | 能力 | 谁用 | 怎么用 |
|---|---|---|---|
| 模型服务层 | 调用 Qwen 全系列 + DeepSeek、Kimi、GLM 等第三方模型 | 开发者 | 兼容 OpenAI 接口,几行代码接入 |
| 应用构建层 | 可视化搭建智能体、工作流、知识库 | 业务人员 / 开发者 | 零代码拖拽 + 高代码两种模式 |
| 模型调优层 | SFT 微调、DPO 偏好优化、模型评测与部署 | AI 工程师 / 算法团队 | 可视化操作,无需手写训练代码 |
1.4.7 实战:30 分钟搭建第一个智能体
以下是从零搭建一个企业知识库问答智能体的完整步骤,照着做就能跑通。
前置准备
- 一个阿里云账号(建议企业实名认证,功能更多);
- 开通百炼服务(控制台搜索"百炼"→ 开通,新用户有免费额度);
- 准备 3~5 份企业文档(产品手册、SOP、FAQ 等,用于知识库测试)。
第一步:创建知识库(RAG)
知识库是企业智能体的"大脑外挂"——把公司的文档、手册、FAQ 放进去,AI 回答时会从里面检索,基于你的资料回答,显著减少幻觉。
- 登录百炼控制台 → 左侧「应用开发」→「知识库」;
- 点击右上角「+ 创建知识库」;
- 基础配置:
- 名称:如"XX 公司产品知识库";
- 知识库类型:选择文档搜索(支持文档/图片/Excel 混合,覆盖面最广);
- 应用场景:基础文档问答(通用场景首选);
- 嵌入模型:默认
text-embedding-v3即可(综合性能优秀); - 点击「确认创建」。
为什么要知识库? 大模型的知识是训练时学的,不知道你们公司的产品、流程、制度。RAG(检索增强生成)就是在回答之前先从你的文档里搜相关内容,再基于搜到的内容生成答案——相当于"开卷考试",答案更准、更可信。
第二步:上传文档并处理
- 进入刚创建的知识库 → 点击「添加文档」;
- 选择上传方式:
- 本地上传:拖拽文件上传,支持 PDF、Word、Excel、PPT、txt、md 等格式;
- 网页爬虫:输入网址,自动抓取网页内容;
- OSS 导入:企业已有文件存在阿里云 OSS 时使用;
- 上传后系统自动切片 + 向量化(把文档拆成小段,每段转成向量存起来,方便检索);
- 等待处理完成(10 份文档通常几分钟内完成)。
文档质量决定答案质量,以下是优化建议:
- 文档内容要清晰、结构化,不要扫描件(OCR 识别误差会影响效果);
- 一份文档不要太长(超过 100 页的可以拆分);
- 内容越准确、越新越好——旧文档会给出旧答案。
第三步:创建智能体应用(Agent 2.0)
- 左侧「应用开发」→「应用管理」→ 点击「创建应用」;
- 选择应用类型:智能体应用(Agent 2.0)(推荐,自主规划能力更强);
- 填写应用名称,点击「立即创建」;
- 自动跳转到配置界面。
Agent 1.0 vs 2.0 怎么选?
表 1-24 通义千问 Agent 1.0 与 2.0 对比
| 对比维度 | Agent 1.0(旧版) | Agent 2.0(新版,推荐) |
|---|---|---|
| 规划调度 | 先检索知识库,再决定调不调其他工具 | 知识库 + 插件 + MCP 统一为工具,自主规划调用顺序 |
| 过程透明 | 只展示最终结果 | 完整展示"规划-执行-反思"全过程 |
| 适用场景 | 意图单一、流程固定的简单任务 | 从简单问答到复杂规划的各类任务 |
一句话:简单问答用 1.0 也够,但 2.0 是未来方向,新应用直接选 2.0 就好。
第四步:配置智能体能力
创建完成后,在配置页依次设置以下几项:
① 选择模型
- 点击模型选择器 → 选择一个模型;
- 新手推荐:
千问-Plus-Latest(效果和成本均衡); - 复杂任务推荐:
千问-Max-Latest(推理强、支持思考模式,但更贵); - 可配置参数:
- 温度系数(temperature):控制随机性。客服问答设低一点(0.1~0.3),创意写作设高一点(0.7~1.0);
- 最长回复长度:控制输出 token 上限;
- enable_thinking:开启思考模式(仅 Max 系列支持),提升复杂推理效果。
② 配置系统提示词
系统提示词就是"给 AI 定规矩"——告诉它你是谁、该干什么、不该干什么。
一个好的系统提示词模板:
你是 XX 公司的客户服务助手,负责回答客户关于产品使用、售后政策的常见问题。

【角色定位】
- 你是专业、友好的客服人员
- 使用中文回答,语气亲切但正式
- 遇到不确定的问题,明确说"抱歉,这个问题我需要确认一下",不要编造

【回答规范】
- 只基于知识库中的内容回答,知识库中没有的就说不知道
- 回答简洁明了,分点说明更好
- 涉及金额、时间等数字,务必准确
- 如果用户问题不明确,主动反问澄清

【工具使用】
- 优先从知识库检索答案
- 知识库没有相关内容时,可以礼貌告知
③ 添加知识库
- 在左侧能力列表找到「知识库」→ 点击添加;
- 选择刚才创建的知识库;
- 配置检索策略:
- 检索块数:默认 3~5 块即可,太多会占用上下文,太少信息不全;
- 相似度阈值:控制检索精度,0.6~0.7 是通用值;
- 召回模式:优先选"向量检索 + 关键词召回"的混合模式,更准。
④ 配置内置工具(按需开启)
Agent 2.0 内置 7 个沙箱工具,默认关闭,按需开启,见表 1-25:
表 1-25 通义千问工具开关
| 工具 | 功能 | 什么时候开 |
|---|---|---|
bash |
执行 shell / python 命令 | 需要数据分析、跑脚本时 |
write / read / edit |
文件读写编辑 | 需要创建或修改文件时 |
glob / grep |
文件搜索 | 需要在一堆文件里找内容时 |
download_file |
产物下载 | 需要把生成的文件给用户时 |
安全原则:默认关闭 = 默认安全。只在确实需要的时候才开,用多少开多少——这和第二部第 12 章"最小权限原则"完全一致。
第五步:测试与调试
配置好后,在右侧的预览对话框里直接测试:
- 先问几个基础问题,比如"你是谁?""咱们公司产品有哪些?";
- 再问一些知识库中的具体问题,验证答案是否准确、有没有引用文档;
- 问一个知识库没有的问题,看 AI 会不会"胡说"——如果会,回系统提示词里加上"不知道就说不知道"。
调试技巧:
- 看一下「规划-执行-反思」链路——Agent 2.0 会展示它的思考过程,能帮你理解它为什么这么答;
- 答案不准 → 先检查知识库文档质量,再调检索策略,最后才考虑换模型;
- 可以开启「深度思考」模式(Max 模型),让 AI 在回答前先"想清楚"。
第六步:发布应用
测试满意后,点击右上角「发布」→ 确认发布。发布后就可以对外使用了。
发布渠道(在「发布渠道」页签配置),见表 1-26:
表 1-26 通义千问的接入渠道
| 渠道 | 适合场景 | 接入方式 |
|---|---|---|
| 网页嵌入 | 官网、后台系统集成 | 复制嵌入代码,贴到网页里 |
| 钉钉机器人 | 企业内部使用 | 钉钉群里添加机器人 |
| 微信公众号 | 对外客户服务 | 公众号后台配置 |
| API / SDK | 自有系统深度集成 | 兼容 OpenAI 接口,几行代码调用 |
| 音视频互动 | 直播、客服场景 | 对接音视频平台 |
发布前检查清单: * [ ] 系统提示词里有没有说"不知道就说不知道"? * [ ] 知识库文档是不是最新的? * [ ] 只开了需要的工具吗?(最小权限原则) * [ ] 有没有测试过 10 个以上典型问题? * [ ] 成本和用量限额设置好了吗?
1.4.8 进阶:Managed Agents 云端托管运行
如果你的智能体需要持续在云端运行(而不是只回答问题),比如自动跑数据分析、定时处理业务、执行长任务,那就需要 Managed Agents——百炼的云端托管智能体运行服务。
四步快速上手
- 配置智能体:填写名称、选择模型、写系统提示词、选工具;
- 配置运行环境:选择云端托管,设置预装的 pip 包(如 pandas、numpy);
- 发起会话:上传文件(可选),输入第一个任务,智能体在云端沙箱里开始执行;
- 查看结果:在控制台看执行过程,下载生成的文件。
适合的场景
- 数据分析师:上传 CSV → 让 Agent 在云端做清洗、统计、可视化 → 下载报告;
- 代码开发者:把代码任务丢给云端 Agent 跑,不占本地资源;
- 批量处理:大量文档/图片的批处理任务,在云端并行跑;
- 企业后端集成:通过 API 调用,把 Agent 能力嵌入自有业务系统。
1.4.9 百炼智能体内置沙箱工具
百炼 Agent 2.0 内置了一套运行在隔离沙箱中的工具,相当于第二部第 16 章"运行时基础设施"的云端版,见表 1-27:
表 1-27 工具与第二部章节的对应
| 工具 | 功能 | 对应第二部章节 |
|---|---|---|
bash |
执行 shell 命令(bash、python3、pip) | 16.2 执行引擎 |
write / read / edit |
文件创建、读取、精确替换 | 15.3 文件型记忆 |
glob / grep |
文件模式搜索、内容搜索 | 16.1 检索能力 |
download_file |
产物导出下载 | 16.5 结果交付 |
这些工具默认关闭、按需开启。默认关闭 = 默认安全——这是企业级平台的设计原则,与第二部第 12 章"最小权限原则"完全一致。
1.4.10 发布与集成:从"做出来"到"用起来"
百炼智能体做好后,可以一键发布到多个渠道:
- API / SDK 调用:嵌入企业自有系统;
- 钉钉机器人:企业内部 IM 即问即用;
- 微信公众号:对外客户服务;
- 网页嵌入:官网/后台集成。
A2A 协议值得注意——百炼支持 Agent-to-Agent 协议,可以构建多个分工明确的智能体协同工作的系统(如"客服 Agent + 技术支持 Agent + 工单 Agent"组成服务链)。这呼应了第二部第 16 章"多智能体协同"的架构模式。
1.4.11 学习路径:从使用者到建设者
表 1-28 通义千问学习路线
| 阶段 | 时长 | 掌握内容 | 能做什么 |
|---|---|---|---|
| 入门期 | 1 天 | 注册开通、模型选择、网页端对话 | 能用通义千问聊天、写文档 |
| 熟练期 | 1 周 | 文档处理、深度思考、PPT 生成、API 调用 | 日常办公全场景能用 |
| 进阶期 | 2~4 周 | 搭建知识库、创建 Agent 2.0、配置插件、发布到钉钉 | 能给团队/部门做一个专属智能体 |
| 精通期 | 1~2 月 | Managed Agents、模型微调、工作流编排、多智能体协同、运维监控 | 能搭建企业级 Agent 平台 |
1.5 其他工具速览与选型对比
表 1-29 主流 AI 工具速览
| 工具 | 厂商 | 强项 | 适合谁 |
|---|---|---|---|
| DeepSeek | 深度求索 | 推理、代码、数学 | 开发与逻辑分析 |
| Kimi | 月之暗面 | 超长文本阅读 | 论文、长文档分析 |
| 豆包 | 字节 | 中文生成、多模态 | 内容创作、日常问答 |
| ChatGPT | OpenAI | 生态与通用能力 | 全球化协作 |
| Claude | Anthropic | 长上下文、MCP 标准发起者 | 开发者、复杂文档 |
选型口诀:明确任务优先用专业工具(办公用 WorkBuddy / TRAE Work,长文本用 Kimi / 千问,代码用 DeepSeek / TRAE Work Code 模式);不确定时先用"Auto 自动模式"。
1.6 通用操作心法(跨工具适用)
无论用哪款工具,以下方法能显著提升效果:
- 把话说完整:给背景、给目标、给约束,不给一句"帮我处理一下";
- 一次一件事:复杂任务拆步骤,或用 Plan 模式先出方案;
- 用文件喂上下文:能上传文件/截图就别只靠文字描述;
- 善用"规则/记忆":把常用偏好一次配置,长期生效;
- 先看结果再追问:AI 交付后先检查产物,再要求迭代;
- 留意"参考信息":AI 引用哪些来源,决定了答案是否可靠(呼应第 3 章)。
1.6.1 给智能体下指令:三种经过实证的高效句式
能不能把一句话"问对、说明白",直接决定 AI 的交付质量。大量真实工程协作的复盘表明,高效输入有三种稳定句式:
- 目标 + 约束:先一次说清"最终要什么 + 受什么约束",再谈做法,不要只丢半句需求让 AI 猜;
- 先方案后实施:复杂任务先说"先出方案/清单 → 我确认 → 再动手"。直接让 AI 闷头做大改,极易返工;
- 只分析不改:当你只想让 AI"看/查"时,必须显式写下"不修改代码/别急着改"——否则工具倾向于直接动手改代码。
1.6.2 给 AI 报缺陷的正确姿势
报缺陷不是描述症状,而是给 AI 一条"可定位、可实证"的线索链:
- 给"症状 + 触发场景 + 期望行为",让 AI 先根因实证,而不是按你的结论直接改;
- 附定位线索:报错信息、失败样例、涉及模块/函数、对应的版本号;
- 划边界、只修一个:明确"不顺手重构 / 美化 / 补注释",把顺带发现的问题记入待办而非混入本次;
- 先要改动范围清单:任何跨多个文件的改动,先让 AI 列出"文件 + 函数 + 改动目的"清单,确认后再落地。
1.6.3 三个最容易踩的协作雷区
- 一次塞太多需求:上下文一膨胀,AI 顾此失彼、改多错多——应单点聚焦、分批推进;
- 全信 AI 自述"已成功":文字说成功不等于真的落盘/生效。要 AI 交付可复核的证据(测试通过数目、产物差异、真实渲染),写文件后要校验确实写入;
- 不设负面约束:只说要什么、不说"不能做什么",AI 常会顺手重构无关部分。把"不要做什么"同样写进指令,价值不亚于正面要求。
1.7 软件配置实用指南:五步把工具调成"可用的状态"
本章前 6 节讲"怎么用",本节讲"怎么配"。同样一款工具,配不配、怎么配,效果可以差一个数量级。本节汇总五类最关键的配置——大模型切换、规则设置、项目记忆、用量查看、MCP 连接器——五步配好一款工具(如图 1-9 所示),就可以从"能聊"进入"能干活"。
图 1-9 新工具配置五步法
flowchart LR
    A[拿到一款新 AI 工具] --> B{先做什么}
    B -->|1| C[大模型切换<br>选对引擎]
    B -->|2| D[规则设置<br>定好规矩]
    B -->|3| E[项目记忆<br>续上上下文]
    B -->|4| F[用量查看<br>控住成本]
    B -->|5| G[MCP 连接器<br>接上外部]
    C & D & E & F & G --> H[工具进入稳定可用状态]
1.7.1 大模型切换:选对引擎,事半功倍
不同模型擅长不同任务,用错模型是"感觉 AI 很笨"的头号原因。主流工具都允许切换默认模型,见表 1-30:
表 1-30 按场景选择模型
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 日常问答 / 润色 / 格式整理 | 轻量或均衡模型 | 快、省积分,质量已够用 |
| 写代码 / 复杂推理 / 调试 | 推理型模型(如 DeepSeek) | 推理链更完整,减少低级错误 |
| 长文档 / 合同比对 / 论文 | 长上下文模型(如 KIMI、千问 Max) | 窗口大,不用手动分段 |
| 不确定该用哪个 | Auto 自动模式 | 让工具按任务自动选择 |
切换路径速查(以各产品 2026 年界面为准):
- WorkBuddy:对话区底部下拉 → 选模型;也可在设置里填入 OpenAI 兼容 API Key 接入自定义模型;
- TRAE Work:设置 → 模型 → 选择默认模型,Code 模式可配置编程专用模型;
- 通义千问:头像 → 设置 → 模型偏好 → 设为默认,注意新开的对话才应用。
两个高频坑:
- 切换后没生效:多数产品只对"新对话"应用新模型,旧对话不换;
- 深思考模式被静默忽略:如千问的深度思考仅对 Qwen-Max 生效,在轻量模型下开启会被忽略。
1.7.2 规则设置:一次配置,永久遵守
规则(Rule / 自定义指令)是把个人偏好固化为 AI 行为的最低成本方式。配置后所有对话自动遵守,无需每次重复强调。
通用规则 vs 项目规则,见表 1-31:
表 1-31 规则设置的三种类型
| 类型 | 生效范围 | 适用 |
|---|---|---|
| 通用规则 | 所有对话 | "回答一律使用中文""代码遵循 PEP8""金额必须带单位" |
| 项目规则 | 仅当前项目/工作区 | "本项目禁止修改 docs/ 下文件""日志输出英文" |
配置三步(以 TRAE Work 为例):
- 打开「设置 → 规则 → 新建」;
- 输入规则内容(建议用肯定句,写清约束对象与标准),如"所有回答使用中文,专业术语保留英文原文";
- 保存。同一条规则在后续所有新对话中自动生效。
要点:规则写得越具体越有效。"好好说话"不如"回复控制在 200 字内,先结论后理由"。规则与第二部第 14 章"可训练配置"思想同源——把偏好从"人脑"搬到"配置"。
1.7.3 项目记忆:让 AI 记住你的上下文
记忆(Memory)让 AI 跨对话记住你的偏好、项目背景和约定,避免每次从头说起。
三档记忆的用途,见表 1-32:
表 1-32 记忆类型与使用建议
| 记忆类型 | 存什么 | 使用建议 |
|---|---|---|
| 会话内记忆 | 本轮对话的来龙去脉 | 长任务中途别乱开新会话 |
| 项目记忆 | 该项目的历史结论、约定 | 长期项目务必开启,减少重复解释 |
| 长期/个人记忆 | 跨项目的个人偏好 | 保存"我常用 XX 风格"这类稳定偏好 |
管理入口速查:
- 查看:设置 → 记忆 / 记忆管理,可看到已记住的条目;
- 编辑:发现记错了可手动删除或修正某一条;
- 上下文压缩:对话过长时,点击"压缩/精简上下文"(如 TRAE Work 工作区"参考信息"面板),保留关键信息、丢弃冗余。
要点:记忆是"第二大脑",但也会记错。涉及关键事实(客户名称、合同条款)时仍要核对原文——这正是第 3 章"交叉核验"的用武之地。
1.7.4 用量查看:把积分/Token 花在刀刃上
大模型调用要花钱/积分,超额往往发生在"需求没说清反复改"。用量查看是控制成本的仪表盘:
- 入口:大多数工具在「设置 → 用量 / 账户 / 积分」查看消耗,TRAE Work / WorkBuddy 可在账户页看余额与明细;
- 看什么:今日/累计消耗、余额、剩余额度,部分工具按模型分别统计(推理模型更贵);
- 怎么省:高频低价值任务用轻量模型;需求用"六格任务卡"说清(见 1.3.4);用量告急时切换到省流模型。
自查:如果一周内积分消耗异常快,先查"是不是总在用最贵的模型跑简单任务"。
1.7.5 MCP 连接器:给 AI 接上外部数据与工具
MCP(Model Context Protocol)是"AI 世界的 USB 接口"(详见第 2.2 节方式三)。配置后 AI 可以读取邮箱、文档库、业务系统数据。
配置三步(以 Claude Desktop 为例):
- 安装 MCP Server:
pip install 某-mcp(如kingdee-mcp、erp-mcp,见第 2.4 节); - 声明连接:编辑配置文件
claude_desktop_config.json,写入mcpServers与服务参数(连接地址、账号、密钥); - 重启客户端:连接器出现在工具列表中,对话里 AI 自动调用。
安全提醒:
- 只给 MCP 服务器最小必要权限,不拿管理员 Token;
- 密钥放在环境变量/本地配置,不要提交到代码仓库;
- 生产环境的 MCP 只读优先,写操作必须带确认(呼应第 13 章审批链)。
1.8 本章小结
- 2026 年的 AI 已从"只会说"进化到"还能做",工具按 L1 对话 / L2 工具 / L3 执行 / L4 智能体四层划分(表 1-1);
- 三款主力工具各有锚点:WorkBuddy 强在腾讯生态与技能 / 专家 / 自动化,TRAE Work 强在三端协同与工作区,通义千问强在文档处理与百炼建站;
- 跨工具的通用心法只有一条——把任务说清楚(六格任务卡、提示词四要素),返工率随描述精度下降;
- 配置五步(模型 / 规则 / 记忆 / 用量 / MCP)决定工具能否进入"稳定可用状态",其中规则与记忆是一次配置、长期生效的杠杆;
- 界面随版本变化,可迁移的是心法——本章"任务描述 → 执行 → 验收 → 沉淀"的闭环,与第二部第 8 章"生成—裁决"同构。